

مجال بحثي · تطوير البرمجيات وكيلي
حين يشارك وكلاء البرمجة في الكتابة: تأمين الشيفرة وسلسلة الأدوات بشكل قابل للتحقق
يكتب وكلاء البرمجة الشيفرة، وينفّذون الأوامر في الطرفية، ويدمجون خوادم MCP والمهارات (Skills). وبذلك يمتد سطح الهجوم من الشيفرة المولَّدة مرورًا ببيئة التشغيل (Harness) حتى الإضافات وخطوط الإنتاج (Pipelines). ونبحث أين يساعد تحليل الشيفرة المدعوم بالذكاء الاصطناعي على نحو مُثبَت، وأين يصبح هو نفسه عرضة للهجوم، ونترجم ذلك إلى Secure SDLC يقدّم فيه النموذج اللغوي المشورة ولا يتحكم.
- وكلاء البرمجة وبيئة التشغيل
- Slopsquatting
- AI-SAST
- التحقق من الاستغلال
- DAST مع LLM محدود الدور
- Secure SDLC
- أمن خطوط CI/CD
- دراسات معمّقة
- 8
- أوراق بيضاء
- 5
- حلول
- 2
من المساعد إلى الوكيل: سلسلة الأدوات تصبح سطح هجوم
يولّد الذكاء الاصطناعي اليوم جزءًا كبيرًا من الشيفرة الجديدة – وتذكر Google نسبة 75% –، وهذه الشيفرة تُدخل الثغرات بوتيرة أعلى على نحو قابل للقياس: فوفقًا لـ Veracode تفشل 45% من عينات الذكاء الاصطناعي في الاختبار الأمني. وفي الوقت نفسه يتحول المساعد الذي يقترح إلى وكيل يثبّت في الطرفية، ويستدعي خوادم MCP، ويحمّل المهارات (Skills). وتختلق النماذج اللغوية في ذلك أيضًا أسماء حزم غير موجودة يمكن للمهاجمين تسجيلها؛ ومنذ 2025 يُسمّى ذلك Slopsquatting.
أظهر يوم 29 أكتوبر 2026 مدى قابلية سلسلة الأدوات للهجوم: فعبر متجر الإضافات في محرر الأكواد Cursor وُزّعت نسخة متلاعب بها من إضافة Claude Code تتضمن بابًا خلفيًا عبر SSH – تحت المعرّف الأصلي anthropic.claude-code. ويذكر تحليلنا الصادر في 31 أكتوبر 2026 خطوات الفحص والتدابير. وتعمل الإضافات بصلاحيات المستخدم المسجّل دخوله، وتصل إلى الشيفرة المصدرية وبيانات الاعتماد والطرفيات؛ ونادرًا ما تخضع سلسلة التوريد هذه على أجهزة المطورين لرقابة صارمة كتلك المفروضة على الخوادم أو خطوط البناء (Build Pipelines).
وعلى جانب التحليل يصبح العثور على الثغرات سلعة متاحة للجميع: فقد أبلغ Google Big Sleep في 2025 عن عشرين ثغرة حقيقية من نوع يوم الصفر، ووجد المتأهلون إلى نهائيات DARPA AI Cyber Challenge في أغسطس 2025، باستقلالية كاملة، 86% من الثغرات المزروعة. لكن حتى نماذج Frontier لا تزال تفشل أمام ثغرات يوم الصفر التي لم تُرَ من قبل فعلًا، والتصنيف الساذج بنماذج LLM دون سياق بالكاد يتجاوز رمي العملة. فالذكاء الاصطناعي يُكمّل طبقات الفحص ولا يحل محلها – وعلى هذا المبدأ تعمل VamiAppSec وVamiDAST.
أسئلة مفتوحة من الممارسة العملية
- 01
كيف تُفحص الشيفرة التي كتبتها مساعدات الذكاء الاصطناعي ووكلاء البرمجة؟
نهجنا
كما تُفحص الشيفرة البشرية – بالمراجعة وSAST والاختبارات وفحص الاعتماديات –، لكن مع التركيز على الفئات التي تفشل فيها شيفرة المساعدات على نحو متوقع: التفويض، والفصل بين المستأجرين، ومعالجة الأخطاء. ويحصل مالكو الشيفرة (Code Owners) على دليل إرشادي لذلك. وتُفحص معها مخاطر الوكلاء والموجّهات في المستودع، مثل ملفات القواعد التي تحتوي على أحرف غير مرئية لا يراها البشر في المراجعة، لكن النموذج يتبعها.
- 02
هل يمكن لنموذج لغوي أن يحل محل SAST القائم على القواعد؟
نهجنا
لا. يبقى SAST القائم على القواعد النظافة الأساسية القابلة للتكرار على كل Commit، والطبقة الوحيدة التي تصلح بوابةً في عملية البناء. ونستخدم AI-SAST مع الاستدلال الدلالي بشكل موجّه على المستودعات عالية القيمة، مثلًا في مواجهة التفويض المعطوب وأخطاء منطق الأعمال. وتحصل نتائج الذكاء الاصطناعي على سجل تدقيق وعينات بشرية للمراجعة، لأن أحكام نماذج LLM تتفاوت بين مرات التشغيل.
- 03
كيف تتحول نتيجة في الشيفرة إلى أولوية موثوقة؟
نهجنا
عبر سلسلة إثبات: قاعدة أو نموذج يُعلّم موضعًا، ثم تُفحص قابلية الوصول والتعرّض الفعلي وقابلية الاستغلال على النظام العامل. وما يكمن خلف المسار يحدد ترتيب المعالجة. ولذلك نتفق على اتفاقيات SLA حسب قابلية الاستغلال بدلًا من CVSS وحده، ونسلّم المسارات المؤكَّدة مع خطوات إعادة الإنتاج إلى مالكي الشيفرة.
- 04
ما مقدار النموذج اللغوي الذي يحتمله اختبار أمني ديناميكي؟
نهجنا
بالحد الأدنى الضروري، ولا يكون أبدًا في موقع القيادة. ففي VamiDAST يتحكم محرك حتمي في كل فحص؛ ولا يقدّم نموذج LLM المشورة إلا في ثلاثة مواضع محدودة بعينها، ومن دون LLM تواصل أدوات الكشف الحتمية عملها. وكل نتيجة مدعومة بالحمولة (Payload) ودليل الاستجابة، ولا تُفحص أنظمة الإنتاج إلا في الوضع السلبي أو الآمن وبتفويض فقط.
ما نخلص إليه
- 01
الهجوم يستهدف بيئة التشغيل (Harness)، لا النموذج
يتكوّن وكيل البرمجة من نموذج وبيئة تشغيل (Harness)، من ملفات القواعد مرورًا بالطرفية وخوادم MCP حتى المهارات (Skills) والأسرار والشبكة. وتصيب الهجمات الموثّقة بيئة التشغيل هذه في كل الحالات تقريبًا؛ إذ وجدت سلسلة الأبحاث IDEsaster أكثر من 30 ثغرة مع 24 CVE في بيئات التطوير المدعومة بالذكاء الاصطناعي. وحيثما أجرى المصنّعون إصلاحات، لم يكن ذلك في النموذج، بل في بيئة التشغيل.
المرجع: Slopsquatting ووكلاء البرمجة
- 02
من يخترق عملية البناء يصيب كل مُخرَج يُسلَّم
تجمع خطوط CI/CD صلاحيات على المستودعات وسجلات الحزم والبيئات السحابية. وفي Poisoned Pipeline Execution يكفي الوصول إلى نظام الشيفرة المصدرية للتلاعب بعملية البناء. والفعّال هنا مُشغّلات (Runners) معزولة دون أسرار (Secrets) للشيفرة غير المُراجَعة، وإعدادات CI من فروع محمية، وبيانات اعتماد OIDC قصيرة الأمد بدلًا من الأسرار الثابتة.
المرجع: أمن خطوط CI/CD
- 03
فرز النتائج بنماذج LLM مُثبَت – لكن محلل الذكاء الاصطناعي يصبح هو نفسه هدفًا
خلف ماسح حتمي يخفض مرشح LLM الإنذارات الكاذبة باتساق، وعلى OWASP Benchmark بنسبة 88.6% مع فقدان 3.1% من الاستدعاء (Recall). وفي الوقت نفسه يعالج النموذج التعليقات وملفات README والمشكلات (Issues) بوصفها مدخلات: إذ تخدع التعليقات العدائية أدوات الكشف القائمة على LLM في أكثر من 90% من الحالات. ومن يستخدم الذكاء الاصطناعي في تحليل الشيفرة يجعله بذلك هو نفسه سطح هجوم.
المرجع: AI-SAST
- 04
توقيت تقديم النتائج هو ما يحدد أثر SAST
لدى Meta كانت نسبة الإصلاح في عمليات الفحص الليلية المجمَّعة قريبة من الصفر. وحين انتقل التحليل نفسه في شكل تعليق إلى مراجعة الشيفرة على الفروقات (Diff)، ارتفعت إلى أكثر من 70% – بالمحرك نفسه ومعدل الإنذارات الكاذبة نفسه. ولا تسمح Google في المراجعة إلا بالتحليلات التي يبقى معدل إنذاراتها الكاذبة الفعلي دون 10%. فالنتائج تُحدث أثرها حيث يعمل المطورون أصلًا.
المرجع: SAST
كيف نعمل
نفصل باتساق بين ما يمكن فحصه بشكل حتمي، وأين يقدّم النموذج اللغوي المشورة، وأين يقرر البشر – من بيئة تشغيل وكيل البرمجة (Harness) مرورًا بطلب الدمج (Pull Request) حتى التطبيق العامل.
تحليل بيئة تشغيل وكلاء البرمجة (Harness)
رصد ملفات القواعد والمدخلات والطرفية وخوادم MCP والمهارات (Skills) ومديري الحزم والأسرار والمستودع والشبكة بوصفها علاقات ثقة، وتأمينها خارج النموذج.
ثلاث طبقات لتحليل الشيفرة
SAST قائم على القواعد على كل Commit، وAI-SAST مع استدلال دلالي على المستودعات عالية القيمة، وتحليل بنماذج Frontier قائم على المخاطر ودوري.
التحقق من الاستغلال
من النتيجة مرورًا بقابلية الوصول والتعرّض حتى قابلية الاستغلال: تُؤكَّد النتائج على النظام العامل قبل أن تحدد الأولويات.
DAST مع LLM محدود الدور بصرامة
VamiDAST: محرك حتمي، ونموذج LLM يقدّم المشورة في ثلاثة مواضع محدودة بعينها؛ واختبارات بعد تسجيل الدخول، وBOLA/IDOR مع هوية ثانية، وكل نتيجة مدعومة بدليل الاستجابة.
تحصين خطوط الإنتاج
OWASP Top 10 CI/CD Security Risks بوصفها إطارًا للفحص: مُشغّلات (Runners) معزولة دون أسرار للشيفرة غير المُراجَعة، وبيانات اعتماد OIDC قصيرة الأمد، ومُخرجات موقّعة مع شهادات المنشأ (Provenance) وفق SLSA.
المعايير وأبطال الأمن
OWASP ASVS 5.0 وCWE Top 25 وNIST SSDF بوصفها معيارًا مرجعيًا، وOWASP SAMM لمستوى النضج؛ ويرسّخ أبطال الأمن (Security Champions) المعرفة الأمنية في كل فريق تطوير.
هكذا تبدؤون
- 1جرد سلسلة الأدواترصد وكلاء البرمجة والإضافات وخوادم MCP ومصادر الحزم وخطوط الإنتاج، وتصنيف المستودعات حسب درجة التعرّض وفئة البيانات.
- 2تحديد الطبقات والبواباتتحديد التحليل الذي يعمل على كل مستودع وبأي إيقاع؛ وتحظر بوابات الجودة (Quality Gates) في GitLab أو GitHub أو Azure DevOps النتائج الحرجة.
- 3إثبات النتائج وتقديم الأدلةتأكيد قابلية الاستغلال على النظام، وتسليم التصحيحات إلى مالكي الشيفرة، وإنتاج أدلة إثبات لكل إصدار لأغراض CRA وNIS2 وتدقيقات العملاء.
دراسات معمّقة وأوراق بيضاء وتحليلات
دراسات معمّقة 8
أوراق بيضاء 5
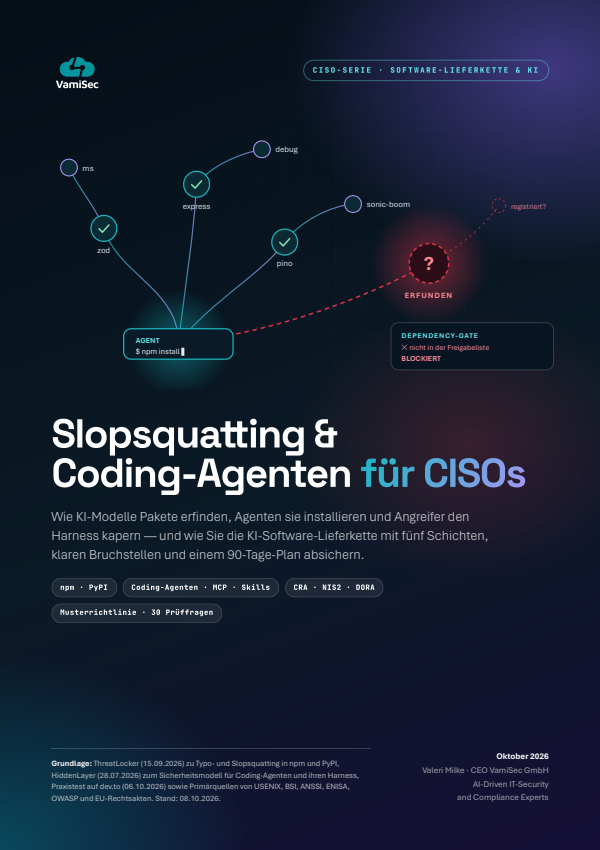 Slopsquatting ووكلاء البرمجة لـ CISOs — تأمين سلسلة توريد برمجيات الذكاء الاصطناعي
 الأمن المدعوم بالذكاء الاصطناعي في خط CI/CD
 أمن خطوط CI/CD: كيف يستولي المهاجمون على خط الإنتاج لديكم — وكيف تستعيدونه
 OWASP Top 10 CI/CD Security Risks — دليل عملي مع مطابقة للامتثال
 البرمجة الآمنة في عصر الذكاء الاصطناعي: CWE Top 25 (2025) والأمن بالتصميم
من المجال البحثي إلى التطبيق


مجالات بحثية ذات صلة
وكلاء البرمجة في الفريق – هل سلسلة الأدوات مؤمَّنة؟
نفحص صلاحيات الوكلاء والإضافات وبوابات خطوط الإنتاج وتحليل الشيفرة لديكم، ونبيّن أين يحقق الفحص المدعوم بالذكاء الاصطناعي أكبر أثر لديكم – مع أدلة قابلة للتتبع.