

Domaine de recherche · Modélisation des menaces Agentic
Là où les agents franchissent des frontières de confiance : modéliser les menaces et les rendre vérifiables
Les agents IA planifient, appellent des outils et délèguent du travail. Les menaces naissent donc dans les objectifs, la mémoire et les interactions des agents, et pas seulement dans le code. Nous associons STRIDE pour les composants classiques et MAESTRO de la Cloud Security Alliance pour les sept couches des systèmes agentiques, modélisons les environnements MCP et traduisons les menaces en tests qui échouent en l'absence de preuves.
- MAESTRO
- STRIDE
- MCP Threat Modeling
- OWASP MCP Top 10
- MITRE ATT&CK & ATLAS
- Evidence Contract
- Automotive Threat Matrix
- Deep Dives
- 5
- Livres blancs
- 1
- Solutions
- 1
Pourquoi les modèles de menaces classiques ne suffisent pas pour les agents
STRIDE, PASTA et LINDDUN modélisent des logiciels au comportement prévisible. Aucune de ces méthodes ne couvre systématiquement le comportement imprévisible des agents, le goal misalignment, la collusion entre agents et les risques issus de la chaîne d'approvisionnement de l'IA. La Cloud Security Alliance a publié MAESTRO à cet effet le 6 février 2025 : sept couches, de Foundation Models à Agent Ecosystem, avec Security and Compliance comme couche transversale. Le catalogue OWASP des menaces agentiques fournit le contenu de chaque couche.
Avec le Model Context Protocol, la frontière de confiance se déplace vers un endroit que les modèles classiques ne représentent pas : les descriptions d'outils et les contenus récupérés déterminent à l'exécution quel outil un agent appelle. MCP n'apporte délibérément aucun mécanisme de sécurité propre ; les équipes de développement et de sécurité doivent imposer elles-mêmes les contrôles habituels. Pour les environnements MCP, nous combinons donc trois prismes : STRIDE pour la classe de défaillance, MAESTRO pour l'emplacement dans l'architecture et l'OWASP MCP Top 10 (v0.1, Beta) comme catalogue de risques.
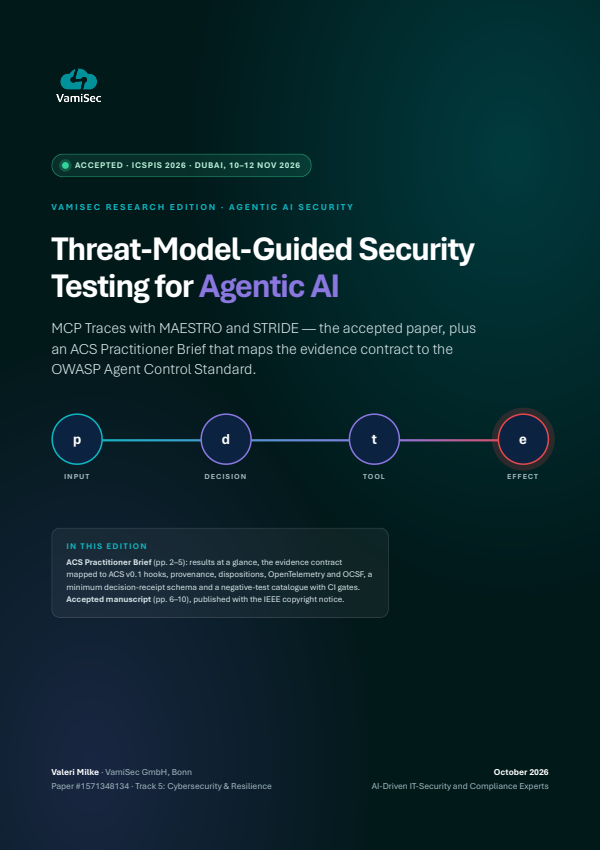
Un modèle de menaces nomme les transitions dangereuses. Seule la télémétrie montre si un agent les respecte en exploitation. Dans son article accepté à l'ICSPIS 2026 (IEEE), Valeri Milke dérive de MAESTRO et STRIDE un Evidence Contract pour les workflows MCP et le teste sur 3 024 cellules avec six familles d'attaques. L'étude utilise des fixtures synthétiques et déterministes ; elle établit de quelles preuves un évaluateur a au minimum besoin pour reconstituer un chemin et le classer comme sûr ou non sûr.
Les questions ouvertes du terrain
- 01
STRIDE et PASTA suffisent-ils pour des systèmes dans lesquels des agents IA agissent de manière autonome ?
Notre approche
Pas à eux seuls. Il manque à STRIDE la prise en compte des menaces propres à l'IA comme les attaques adversariales, PASTA ne traite pas les attaques contre les modèles comme la model extraction, LINDDUN ne couvre pas le data poisoning. MAESTRO ne remplace pas ces méthodes, il les étend : nous utilisons STRIDE pour les composants classiques et déterminons les menaces par couche MAESTRO et entre les couches, avec le catalogue OWASP comme checklist.
- 02
Comment modéliser un environnement MCP dans lequel les outils ne sont choisis qu'à l'exécution ?
Notre approche
Nous relevons les hosts, les clients, les serveurs connectés, les outils et les voies de transport, avec des frontières de confiance explicitement marquées. MCP lui-même se situe sur la couche 3 de MAESTRO ; nous documentons les menaces par couche, avec la catégorie STRIDE, le chemin d'attaque et le lien avec l'OWASP MCP Top 10. La télémétrie et des points de révision font évoluer le modèle avec chaque nouveau serveur et chaque release.
- 03
Comment une menace devient-elle un cas de test vérifiable pour les agents IA ?
Notre approche
Chaque transition dangereuse devient un tuple composé d'une frontière, d'une précondition, d'un invariant, de preuves et d'un oracle. Pour l'Approval Replay, l'invariant exige que l'outil, les arguments, le principal et la cible correspondent, lors de l'appel, aux valeurs validées. L'évaluateur signale la règle violée et la première étape à laquelle les preuves l'établissent. Des jumeaux bénins montrent si un détecteur fait la distinction ou se contente d'une alarme permanente.
- 04
Peut-on automatiser le threat modeling sans perdre en pertinence ?
Notre approche
Oui, si l'automatisation fait passer l'analyse à l'échelle au lieu de la remplacer. Le Threat-Modeling-as-Code rend les modèles versionnables et vérifiables en revue de code ; les listes de menaces générées restent un point de départ. Dans VamiThreat, les descriptions d'architecture donnent naissance à un diagramme de flux de données modifiable avec frontières de confiance ; l'IA enrichit et propose, et votre équipe vérifie les diagrammes interprétés avant leur utilisation.
Ce que nous retenons
- 01
Les menaces agentiques se propagent en cascade d'une couche à l'autre
MAESTRO décompose les systèmes agentiques en sept couches, mais ce sont surtout les menaces qui franchissent les frontières entre couches qui comptent : bibliothèques de frameworks compromises, droits d'accès qui s'élèvent d'une couche à l'autre, goal misalignment d'agents individuels qui se propage en cascade jusqu'à l'écosystème. La démarche de la CSA prévoit pour cela une étape dédiée, avant l'évaluation des risques et la planification des mesures.
Source: MAESTRO
- 02
Chaque serveur MCP joignable constitue une frontière de confiance à part entière
Les serveurs MCP sont majoritairement conçus par des développeurs indépendants et distribués via des registries non officielles ; des labels comme « official » ou « verified » ne confirment ni l'identité ni le lien avec le produit. De nombreux clients exécutent les outils automatiquement et font implicitement confiance aux réponses des outils. Un modèle de menaces évalue donc, pour chaque serveur, la provenance, le comportement en auto-run et les scopes des tokens.
Source: Paysage des menaces
- 03
Aucun catalogue de risques ne couvre à lui seul un environnement MCP
L'OWASP MCP Top 10 (v0.1, Beta) nomme dix risques documentés, du Token Mismanagement au Context Over-Sharing ; la disponibilité n'y figure pas comme entrée distincte. Or la perturbation peut venir de votre propre agent : un modèle doté d'un outil de requête illimité génère des requêtes coûteuses et des pics de charge. STRIDE reste donc nécessaire comme grille, afin qu'aucune catégorie ne passe à la trappe.
Source: MCP Threat Modeling
- 04
Des preuves complètes, d'abord pour les opérations privilégiées
Dans l'expérience ICSPIS, le profil threat-guided a produit en médiane 2 341 octets de JSON canonique par workflow, soit 255,2 % de plus que des logs fragmentés et 88,0 % de plus qu'un tracing causal. Il s'agit d'un indicateur de sérialisation, pas d'une mesure de coûts. La conséquence : des preuves complètes d'abord pour les opérations privilégiées, et l'échantillonnage ne doit supprimer aucun Decision Receipt.
Notre démarche
Nous combinons des méthodes établies avec des extensions propres aux agents. Le résultat n'est pas un document qui finit dans un tiroir, mais un modèle dont découlent des mesures, des cas de test et des exigences de télémétrie.
STRIDE & diagrammes de flux de données
Six classes de menaces, chacune liée à un objectif de sécurité violé, appliquées aux flux de données et aux frontières de confiance – là où les menaces se concentrent.
MAESTRO de la Cloud Security Alliance
Sept couches, de Foundation Models à Agent Ecosystem, avec Security and Compliance en transversal ; les chaînes entre couches font l'objet d'une étape de travail dédiée.
Catalogues OWASP
Catalogue des menaces agentiques comme checklist par couche, OWASP MCP Top 10 (v0.1, Beta) pour les environnements MCP, OWASP Top 10 for Agentic Applications comme contre-vérification du vocabulaire.
Taxonomies d'attaquants
MITRE ATT&CK pour les techniques des attaquants et ATLAS pour les attaques contre les systèmes d'IA, rattachés à chaque composant dans VamiThreat ; pour les véhicules, l'Automotive Threat Matrix comme bibliothèque de chemins.
Evidence Contract
Quatre étapes – Input, Decision, Tool, Effect – avec des liaisons dont un oracle de test contrôle l'égalité ou l'ordre ; base des tests négatifs et des gates CI.
Threat-Modeling-as-Code
Architecture et modèle de menaces sous forme de code versionné : vérifiables en revue, reproductibles dans le pipeline, sans remplacer l'analyse menée ensemble par l'équipe.
Pour démarrer
- 1Décomposer l'architectureRelever les composants, flux de données et frontières de confiance et rattacher chaque composant à une couche MAESTRO – en atelier avec vos équipes ou en accompagnement du cycle de développement.
- 2Évaluer les menacesDéterminer les menaces par couche et entre les couches, les prioriser selon leur probabilité et leur impact, et en déduire un plan de mesures argumenté.
- 3Traduire en testsLes menaces critiques deviennent des hypothèses vérifiables avec invariant et oracle – des tests négatifs avec jumeaux bénins, qui échouent dans le pipeline en l'absence de preuves.
Deep Dives, livres blancs et analyses
Deep Dives 5
Du domaine à la mise en œuvre
Domaines de recherche connexes
Des agents en service – les menaces sont-elles modélisées ?
Lors d'un premier entretien, nous déterminons où vos agents, serveurs MCP et flux de données franchissent des frontières de confiance, et si un atelier, une modélisation en accompagnement ou VamiThreat vous convient le mieux.