

Forschungsfeld · Bedrohungsmodellierung Agentic
Wo Agenten Vertrauensgrenzen überschreiten: Bedrohungen modellieren und prüfbar machen
KI-Agenten planen, rufen Werkzeuge auf und delegieren Arbeit. Bedrohungen entstehen damit in Zielen, Gedächtnis und Interaktionen der Agenten, nicht nur im Code. Wir verbinden STRIDE für klassische Komponenten mit MAESTRO der Cloud Security Alliance für die sieben Schichten agentischer Systeme, modellieren MCP-Landschaften und übersetzen Bedrohungen in Tests, die bei fehlender Evidenz scheitern.
- MAESTRO
- STRIDE
- MCP Threat Modeling
- OWASP MCP Top 10
- MITRE ATT&CK & ATLAS
- Evidence Contract
- Automotive Threat Matrix
- Deep Dives
- 5
- Whitepaper
- 1
- Lösungen
- 1
Warum klassische Bedrohungsmodelle bei Agenten zu kurz greifen
STRIDE, PASTA und LINDDUN modellieren Software mit vorhersagbarem Verhalten. Unvorhersagbares Agentenverhalten, Goal Misalignment, Kollusion zwischen Agenten und Risiken aus der KI-Lieferkette erfasst keine dieser Methoden systematisch. Die Cloud Security Alliance hat dafür am 6. Februar 2025 MAESTRO veröffentlicht: sieben Schichten von Foundation Models bis Agent Ecosystem, Security and Compliance als Querschnittsschicht. Der OWASP-Katalog agentischer Bedrohungen liefert die Inhalte je Schicht.
Mit dem Model Context Protocol verschiebt sich die Vertrauensgrenze an eine Stelle, die klassische Modelle nicht abbilden: Tool-Beschreibungen und abgerufene Inhalte bestimmen zur Laufzeit, welches Werkzeug ein Agent aufruft. MCP bringt bewusst keine eigenen Sicherheitsmechanismen mit, die üblichen Kontrollen müssen Entwicklung und Security selbst erzwingen. Für MCP-Landschaften kombinieren wir deshalb drei Linsen: STRIDE für die Fehlerklasse, MAESTRO für den Ort in der Architektur und die OWASP MCP Top 10 (v0.1, Beta) als Risikokatalog.
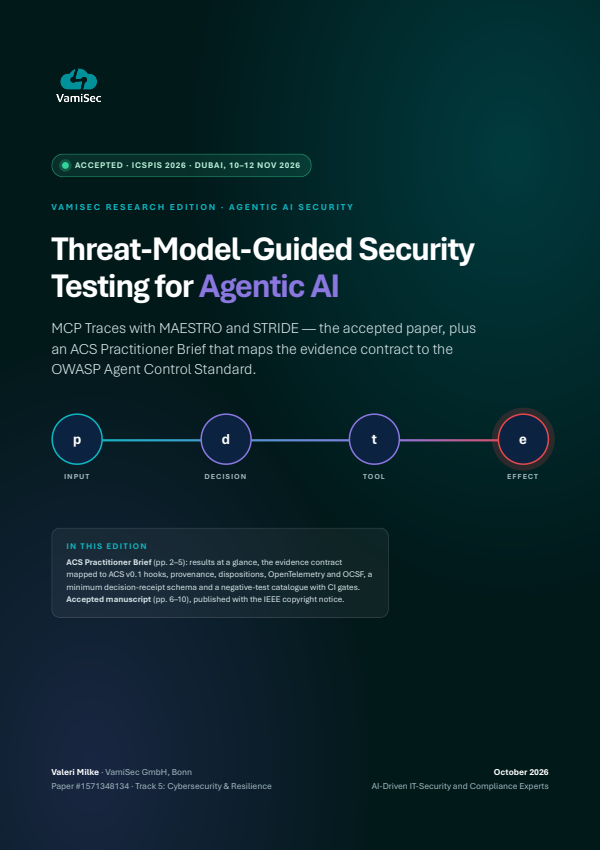
Ein Bedrohungsmodell benennt gefährliche Übergänge. Ob ein Agent sie im Betrieb respektiert, zeigt erst die Telemetrie. In seinem bei der ICSPIS 2026 (IEEE) angenommenen Paper leitet Valeri Milke aus MAESTRO und STRIDE einen Evidence Contract für MCP-Workflows ab und prüft ihn an 3.024 Zellen mit sechs Angriffsfamilien. Die Studie nutzt synthetische, deterministische Fixtures; sie klärt, welche Evidenz ein Evaluator mindestens braucht, um einen Pfad zu rekonstruieren und als sicher oder unsicher zu klassifizieren.
Offene Fragen der Praxis
- 01
Reichen STRIDE und PASTA für Systeme aus, in denen KI-Agenten autonom handeln?
Unser Ansatz
Allein nicht. STRIDE fehlt der Blick auf KI-spezifische Bedrohungen wie Adversarial-Angriffe, PASTA adressiert keine Angriffe auf Modelle wie Model Extraction, LINDDUN deckt Data Poisoning nicht ab. MAESTRO ersetzt diese Methoden nicht, sondern erweitert sie: Wir nutzen STRIDE für klassische Komponenten und bestimmen Bedrohungen je MAESTRO-Schicht und schichtübergreifend, mit dem OWASP-Katalog als Checkliste.
- 02
Wie modelliert man eine MCP-Landschaft, in der Werkzeuge erst zur Laufzeit gewählt werden?
Unser Ansatz
Wir erfassen Hosts, Clients, angebundene Server, Werkzeuge und Transportwege mit explizit markierten Vertrauensgrenzen. MCP selbst liegt auf MAESTRO-Ebene 3; Bedrohungen dokumentieren wir je Ebene mit STRIDE-Kategorie, Angriffspfad und Bezug zu den OWASP MCP Top 10. Telemetrie und Wiederholpunkte sorgen dafür, dass das Modell mit jedem neuen Server und jedem Release mitwächst.
- 03
Wie wird aus einer Bedrohung ein prüfbarer Testfall für KI-Agenten?
Unser Ansatz
Jede gefährliche Transition wird zu einem Tupel aus Grenze, Vorbedingung, Invariante, Evidenz und Orakel. Beim Approval Replay verlangt die Invariante, dass Tool, Argumente, Principal und Ziel beim Aufruf den freigegebenen Werten entsprechen. Der Evaluator meldet die verletzte Regel und die erste Stufe, an der die Evidenz sie belegt. Benigne Zwillinge zeigen, ob ein Detektor unterscheidet oder nur Dauer-Alarm gibt.
- 04
Lässt sich Threat Modeling automatisieren, ohne an Aussagekraft zu verlieren?
Unser Ansatz
Ja, wenn Automatisierung die Analyse skaliert, statt sie zu ersetzen. Threat-Modeling-as-Code macht Modelle versionierbar und im Code-Review prüfbar; generierte Bedrohungslisten bleiben Ausgangspunkt. In VamiThreat entsteht aus Architekturbeschreibungen ein editierbares Datenflussdiagramm mit Vertrauensgrenzen; die KI reichert an und schlägt vor, geparste Diagramme prüft Ihr Team vor der Verwendung.
Was wir festhalten
- 01
Agentische Bedrohungen kaskadieren über Schichtgrenzen
MAESTRO zerlegt agentische Systeme in sieben Schichten, besonders relevant sind aber Bedrohungen über Schichtgrenzen hinweg: kompromittierte Framework-Bibliotheken, zwischen Schichten eskalierende Zugriffsrechte, Goal Misalignment einzelner Agenten, das ins Ökosystem kaskadiert. Das CSA-Vorgehen sieht dafür einen eigenen Schritt vor, vor Risikobewertung und Maßnahmenplanung.
Beleg: MAESTRO
- 02
Jeder erreichbare MCP-Server ist eine eigene Vertrauensgrenze
MCP-Server werden überwiegend von unabhängigen Entwicklern gebaut und über inoffizielle Registries verteilt; Labels wie „official“ oder „verified“ bestätigen weder Identität noch Produktbezug. Viele Clients führen Werkzeuge automatisch aus und vertrauen Tool-Antworten implizit. Ein Bedrohungsmodell bewertet daher Herkunft, Auto-Run-Verhalten und Token-Scopes je Server.
Beleg: Bedrohungslandschaft
- 03
Kein Risikokatalog deckt eine MCP-Landschaft allein ab
Die OWASP MCP Top 10 (v0.1, Beta) benennen zehn dokumentierte Risiken von Token-Mismanagement bis Context Over-Sharing, Verfügbarkeit fehlt als eigener Eintrag. Dabei kann die Störung aus dem eigenen Agenten kommen: Ein Modell mit unbegrenztem Abfragewerkzeug erzeugt teure Queries und Lastspitzen. STRIDE bleibt deshalb als Raster nötig, damit keine Kategorie durchfällt.
Beleg: MCP Threat Modeling
- 04
Vollständige Evidenz zuerst für privilegierte Operationen
Im ICSPIS-Experiment erzeugte das threat-guided Profil im Median 2.341 Byte kanonisches JSON pro Workflow, 255,2 % mehr als fragmentierte Logs und 88,0 % mehr als kausales Tracing. Das ist ein Serialisierungs-Indikator, keine Kostenmessung. Die Konsequenz: vollständige Belege zuerst für privilegierte Operationen, und Sampling darf keine Decision Receipts wegschneiden.
Wie wir vorgehen
Wir kombinieren etablierte Methoden mit agentenspezifischen Erweiterungen. Das Ergebnis ist kein Schubladenpapier, sondern ein Modell, aus dem Maßnahmen, Testfälle und Anforderungen an die Telemetrie folgen.
STRIDE & Datenflussdiagramme
Sechs Bedrohungsklassen, je ein verletztes Schutzziel, angewandt auf Datenflüsse und Vertrauensgrenzen – dort, wo sich Bedrohungen konzentrieren.
MAESTRO der Cloud Security Alliance
Sieben Schichten von Foundation Models bis Agent Ecosystem, Security and Compliance als Querschnitt; schichtübergreifende Ketten als eigener Arbeitsschritt.
OWASP-Kataloge
Katalog agentischer Bedrohungen als Checkliste je Schicht, OWASP MCP Top 10 (v0.1, Beta) für MCP-Landschaften, OWASP Top 10 für Agentic Applications als Gegenprobe für das Vokabular.
Angreifer-Taxonomien
MITRE ATT&CK für Angreifertechniken und ATLAS für Angriffe auf KI-Systeme, in VamiThreat je Komponente zugeordnet; für Fahrzeuge die Automotive Threat Matrix als Pfadbibliothek.
Evidence Contract
Vier Stufen – Input, Decision, Tool, Effect – mit Bindungen, deren Gleichheit oder Reihenfolge ein Testorakel prüft; Grundlage für Negativtests und CI-Gates.
Threat-Modeling-as-Code
Architektur und Bedrohungsmodell als versionierter Code: im Review prüfbar, in der Pipeline wiederholbar, ohne die gemeinsame Analyse im Team zu ersetzen.
So starten Sie
- 1Architektur zerlegenKomponenten, Datenflüsse und Vertrauensgrenzen erfassen und jede Komponente einer MAESTRO-Schicht zuordnen – im Workshop mit Ihren Teams oder begleitend im Entwicklungszyklus.
- 2Bedrohungen bewertenJe Schicht und schichtübergreifend Bedrohungen bestimmen, nach Eintrittswahrscheinlichkeit und Wirkung priorisieren und daraus einen begründeten Maßnahmenplan ableiten.
- 3In Tests übersetzenKritische Bedrohungen werden zu prüfbaren Hypothesen mit Invariante und Orakel – Negativtests mit benignen Zwillingen, die in der Pipeline bei fehlender Evidenz scheitern.
Deep Dives, Whitepaper und Analysen
Deep Dives 5
Vom Feld in die Umsetzung
Verwandte Forschungsfelder
Agenten im Einsatz – sind die Bedrohungen modelliert?
Im Erstgespräch klären wir, wo Ihre Agenten, MCP-Server und Datenflüsse Vertrauensgrenzen überschreiten und ob Workshop, begleitende Modellierung oder VamiThreat am besten passt.