

Área de investigación · Modelado de amenazas Agentic
Donde los agentes cruzan límites de confianza: modelar las amenazas y hacerlas verificables
Los agentes de IA planifican, invocan herramientas y delegan trabajo. Así, las amenazas surgen en los objetivos, la memoria y las interacciones de los agentes, no solo en el código. Combinamos STRIDE para los componentes clásicos con MAESTRO, de la Cloud Security Alliance, para las siete capas de los sistemas agénticos, modelamos entornos MCP y traducimos las amenazas en pruebas que fallan cuando falta evidencia.
- MAESTRO
- STRIDE
- MCP Threat Modeling
- OWASP MCP Top 10
- MITRE ATT&CK y ATLAS
- Evidence Contract
- Automotive Threat Matrix
- Deep Dives
- 5
- Whitepapers
- 1
- Soluciones
- 1
Por qué los modelos de amenazas clásicos se quedan cortos con los agentes
STRIDE, PASTA y LINDDUN modelan software con un comportamiento predecible. Ninguno de estos métodos captura de forma sistemática el comportamiento impredecible de los agentes, el goal misalignment, la colusión entre agentes ni los riesgos de la cadena de suministro de la IA. Para ello, la Cloud Security Alliance publicó MAESTRO el 6 de febrero de 2025: siete capas, de Foundation Models a Agent Ecosystem, con Security and Compliance como capa transversal. El catálogo de amenazas agénticas de OWASP aporta los contenidos de cada capa.
Con el Model Context Protocol, el límite de confianza se desplaza a un lugar que los modelos clásicos no representan: las descripciones de herramientas y los contenidos recuperados determinan en tiempo de ejecución qué herramienta invoca un agente. MCP, de forma deliberada, no incorpora mecanismos de seguridad propios; los controles habituales deben imponerlos por sí mismos los equipos de desarrollo y de seguridad. Por eso, para los entornos MCP combinamos tres perspectivas: STRIDE para la clase de fallo, MAESTRO para el lugar en la arquitectura y el OWASP MCP Top 10 (v0.1, Beta) como catálogo de riesgos.
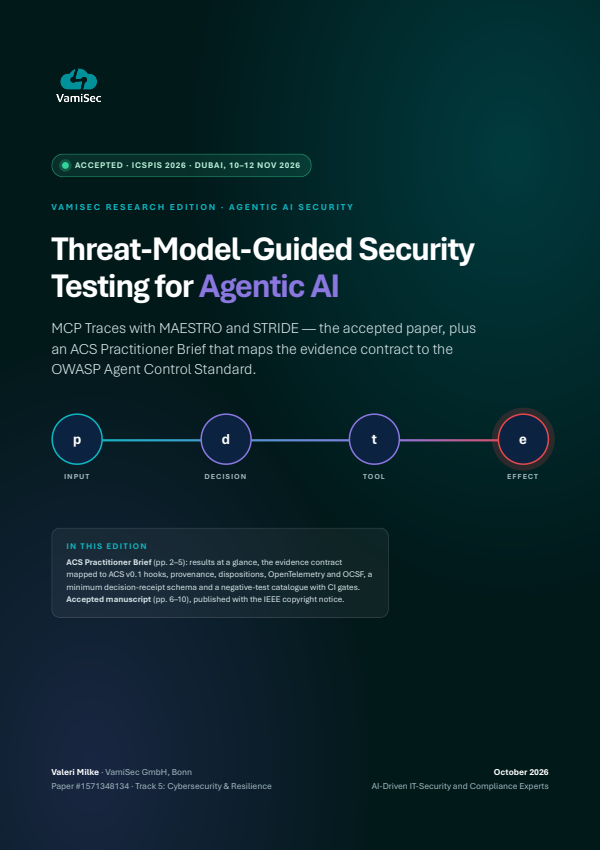
Un modelo de amenazas identifica transiciones peligrosas. Solo la telemetría muestra si un agente las respeta durante la operación. En su artículo aceptado en la ICSPIS 2026 (IEEE), Valeri Milke deriva de MAESTRO y STRIDE un Evidence Contract para flujos de trabajo MCP y lo pone a prueba con 3.024 celdas y seis familias de ataque. El estudio utiliza fixtures sintéticos y deterministas; aclara qué evidencia necesita como mínimo un evaluador para reconstruir una ruta y clasificarla como segura o insegura.
Preguntas abiertas de la práctica
- 01
¿Bastan STRIDE y PASTA para sistemas en los que los agentes de IA actúan de forma autónoma?
Nuestro enfoque
Por sí solos, no. A STRIDE le falta la visión de las amenazas específicas de la IA, como los ataques adversariales; PASTA no aborda los ataques a los modelos, como la model extraction, y LINDDUN no cubre el data poisoning. MAESTRO no sustituye estos métodos, sino que los amplía: utilizamos STRIDE para los componentes clásicos y determinamos las amenazas por capa de MAESTRO y de forma transversal, con el catálogo de OWASP como lista de verificación.
- 02
¿Cómo se modela un entorno MCP en el que las herramientas solo se eligen en tiempo de ejecución?
Nuestro enfoque
Registramos hosts, clientes, servidores conectados, herramientas y vías de transporte con los límites de confianza marcados de forma explícita. El propio MCP se sitúa en la capa 3 de MAESTRO; documentamos las amenazas por capa con su categoría STRIDE, su ruta de ataque y su referencia al OWASP MCP Top 10. La telemetría y los puntos de repetición hacen que el modelo crezca con cada nuevo servidor y cada release.
- 03
¿Cómo se convierte una amenaza en un caso de prueba verificable para agentes de IA?
Nuestro enfoque
Cada transición peligrosa se convierte en una tupla de límite, precondición, invariante, evidencia y oráculo. En el Approval Replay, la invariante exige que la herramienta, los argumentos, el principal y el destino coincidan en la llamada con los valores aprobados. El evaluador informa de la regla vulnerada y de la primera etapa en la que la evidencia la demuestra. Los gemelos benignos muestran si un detector distingue o solo genera una alarma permanente.
- 04
¿Se puede automatizar el Threat Modeling sin perder valor informativo?
Nuestro enfoque
Sí, si la automatización escala el análisis en lugar de sustituirlo. El Threat Modeling as Code hace que los modelos sean versionables y verificables en la revisión de código; las listas de amenazas generadas siguen siendo un punto de partida. En VamiThreat, a partir de descripciones de arquitectura se genera un diagrama de flujo de datos editable con límites de confianza; la IA enriquece y propone, y su equipo revisa los diagramas procesados antes de utilizarlos.
Lo que constatamos
- 01
Las amenazas agénticas se propagan en cascada entre capas
MAESTRO descompone los sistemas agénticos en siete capas, pero son especialmente relevantes las amenazas que cruzan las fronteras entre capas: bibliotecas de frameworks comprometidas, derechos de acceso que escalan entre capas, goal misalignment de agentes individuales que se propaga en cascada al ecosistema. El procedimiento de la CSA prevé para ello un paso propio, previo a la evaluación de riesgos y a la planificación de medidas.
Fuente: MAESTRO
- 02
Cada servidor MCP accesible es un límite de confianza propio
Los servidores MCP los construyen en su mayoría desarrolladores independientes y se distribuyen a través de registries no oficiales; etiquetas como «official» o «verified» no confirman ni la identidad ni la vinculación con el producto. Muchos clientes ejecutan herramientas automáticamente y confían de forma implícita en las respuestas de las herramientas. Por eso, un modelo de amenazas evalúa por servidor el origen, el comportamiento de ejecución automática y los ámbitos de los tokens.
Fuente: Panorama de amenazas
- 03
Ningún catálogo de riesgos cubre por sí solo un entorno MCP
El OWASP MCP Top 10 (v0.1, Beta) recoge diez riesgos documentados, desde la mala gestión de tokens hasta el Context Over-Sharing; la disponibilidad no figura como entrada propia. Sin embargo, la interrupción puede provenir del propio agente: un modelo con una herramienta de consulta sin límites genera consultas costosas y picos de carga. Por eso, STRIDE sigue siendo necesario como matriz, para que no se escape ninguna categoría.
Fuente: MCP Threat Modeling
- 04
Evidencia completa, primero para las operaciones privilegiadas
En el experimento de la ICSPIS, el perfil threat-guided generó una mediana de 2.341 bytes de JSON canónico por workflow, un 255,2 % más que los logs fragmentados y un 88,0 % más que el tracing causal. Es un indicador de serialización, no una medición de costes. La consecuencia: evidencias completas primero para las operaciones privilegiadas, y el sampling no debe eliminar Decision Receipts.
Cómo procedemos
Combinamos métodos consolidados con extensiones específicas para agentes. El resultado no es un documento que acaba en un cajón, sino un modelo del que se derivan medidas, casos de prueba y requisitos de telemetría.
STRIDE y diagramas de flujo de datos
Seis clases de amenaza, cada una con un objetivo de protección vulnerado, aplicadas a los flujos de datos y los límites de confianza: allí donde se concentran las amenazas.
MAESTRO, de la Cloud Security Alliance
Siete capas, de Foundation Models a Agent Ecosystem, con Security and Compliance como capa transversal; las cadenas entre capas, como paso de trabajo propio.
Catálogos de OWASP
El catálogo de amenazas agénticas como lista de verificación por capa, el OWASP MCP Top 10 (v0.1, Beta) para entornos MCP y el OWASP Top 10 for Agentic Applications como contraprueba para el vocabulario.
Taxonomías de atacantes
MITRE ATT&CK para las técnicas de los atacantes y ATLAS para los ataques a sistemas de IA, asignados por componente en VamiThreat; para vehículos, la Automotive Threat Matrix como biblioteca de rutas.
Evidence Contract
Cuatro etapas (Input, Decision, Tool, Effect) con vinculaciones cuya igualdad u orden comprueba un oráculo de prueba; base para pruebas negativas y gates de CI.
Threat Modeling as Code
Arquitectura y modelo de amenazas como código versionado: verificable en la revisión, repetible en el pipeline, sin sustituir el análisis conjunto en equipo.
Cómo empezar
- 1Descomponer la arquitecturaRegistrar componentes, flujos de datos y límites de confianza y asignar cada componente a una capa de MAESTRO, en un taller con sus equipos o de forma continua a lo largo del ciclo de desarrollo.
- 2Evaluar las amenazasDeterminar las amenazas por capa y de forma transversal, priorizarlas según su probabilidad de ocurrencia y su impacto y derivar de ellas un plan de medidas fundamentado.
- 3Traducir en pruebasLas amenazas críticas se convierten en hipótesis verificables con invariante y oráculo: pruebas negativas con gemelos benignos que fallan en el pipeline cuando falta evidencia.
Deep Dives, whitepapers y análisis
Deep Dives 5
Del área a la implantación
Áreas de investigación relacionadas
Agentes en uso: ¿están modeladas las amenazas?
En la primera consulta aclaramos dónde cruzan límites de confianza sus agentes, servidores MCP y flujos de datos, y si encaja mejor un taller, un modelado continuo o VamiThreat.